Nvidia ha lanciato un modello per la trascrizione vocale in 40 lingue
Il 28 ottobre Nvidia ha annunciato il rilascio di Nemotron 3.5 Transcribe. Si tratta di un modello di intelligenza artificiale che converte il parlato in testo in 40 lingue.
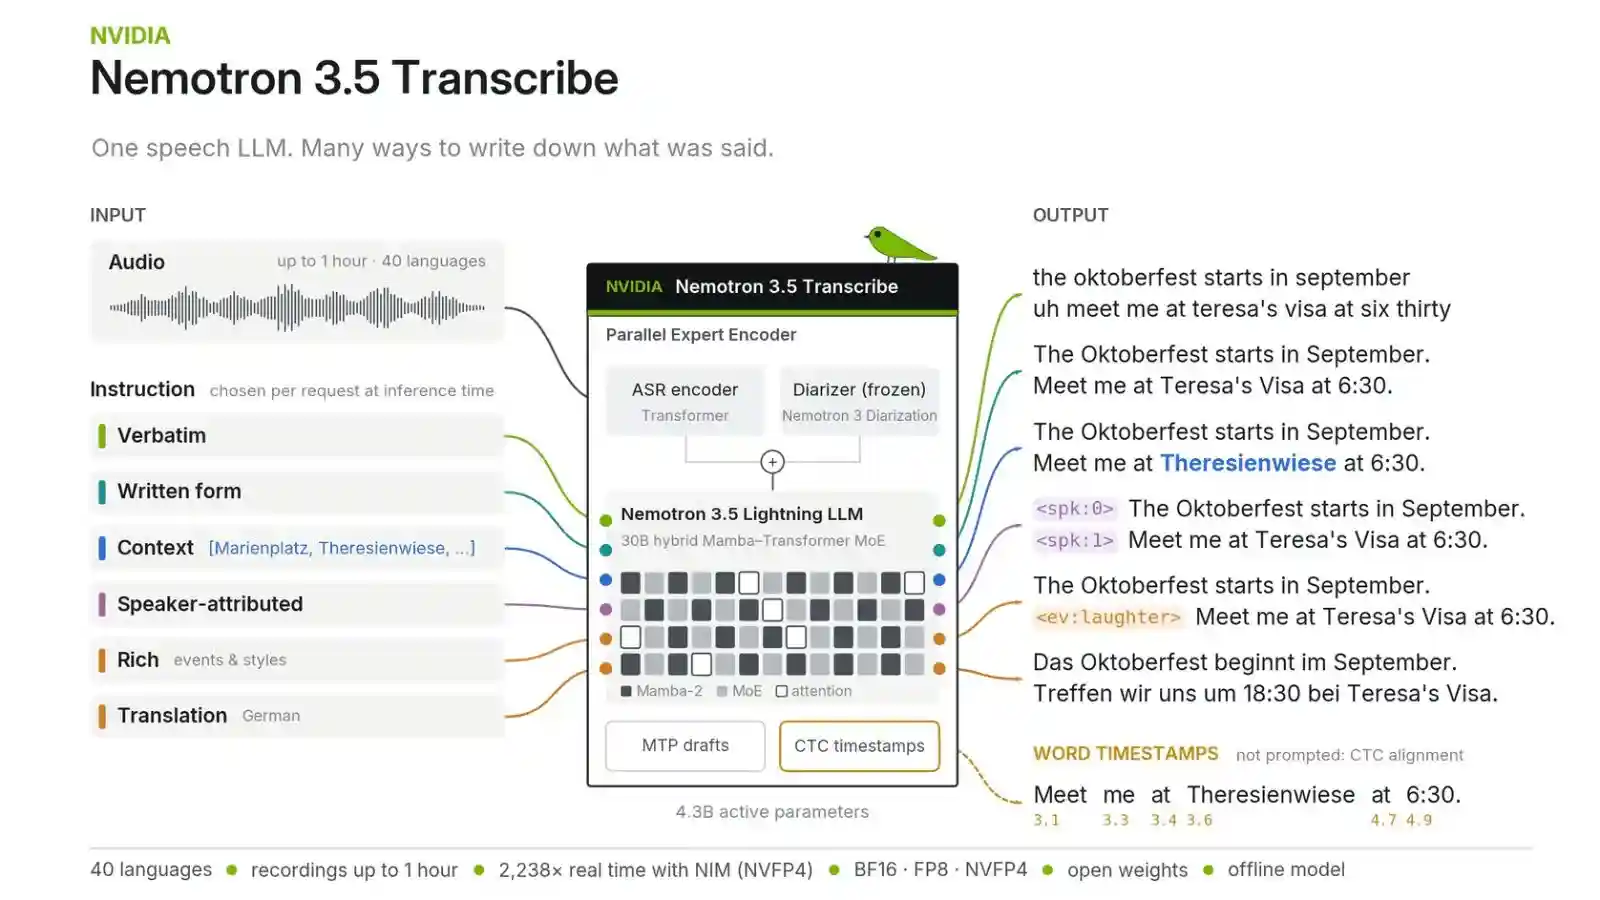
Oltre alla trascrizione, la soluzione traduce dall’inglese in altre 31 lingue. Inoltre individua a quale partecipante appartiene ciascuna battuta, funzione disponibile in 13 lingue. Secondo PC Watch, il modello è in grado di elaborare in un’unica volta una registrazione audio della durata fino a un’ora.
La versione base è già disponibile sulla piattaforma Hugging Face. Nvidia ha reso aperti i pesi del modello, ovvero i parametri necessari per eseguirlo, e ne consente l’uso commerciale gratuito con la licenza OpenMDW-1.1. L’azienda intende rilasciare in seguito le versioni con quantizzazione FP8 e NVFP4. La quantizzazione riduce la precisione di rappresentazione dei parametri, diminuendo così i requisiti di risorse di calcolo e di memoria.
Secondo i risultati del test Hugging Face Open ASR, il tasso medio di errore nel riconoscimento delle parole è stato del 5,33% per l’inglese, del 4,62% per sette lingue e del 10,98% per le registrazioni lunghe. Come dichiara Nvidia, in tutte queste categorie Nemotron 3.5 Transcribe ha superato altri modelli con pesi aperti.
In una verifica separata delle prestazioni, la versione NVFP4 ha elaborato 100 ore di audio in meno di tre minuti. Il test è stato eseguito su una macchina con un singolo acceleratore Nvidia RTX PRO 6000 Blackwell Server Edition. Questo risultato si riferisce a una configurazione specifica e non indica la stessa velocità di elaborazione di una registrazione di un’ora su qualsiasi dispositivo.
Il modello può già essere distribuito tramite vLLM. L’esecuzione in locale con NeMo-Speech.cpp sarà disponibile contemporaneamente alle versioni quantizzate.