Nvidia、40言語対応の音声文字起こしモデルを公開
Nvidiaは10月28日、Nemotron 3.5 Transcribeを発表した。音声を40言語でテキストに変換するAIモデルである。
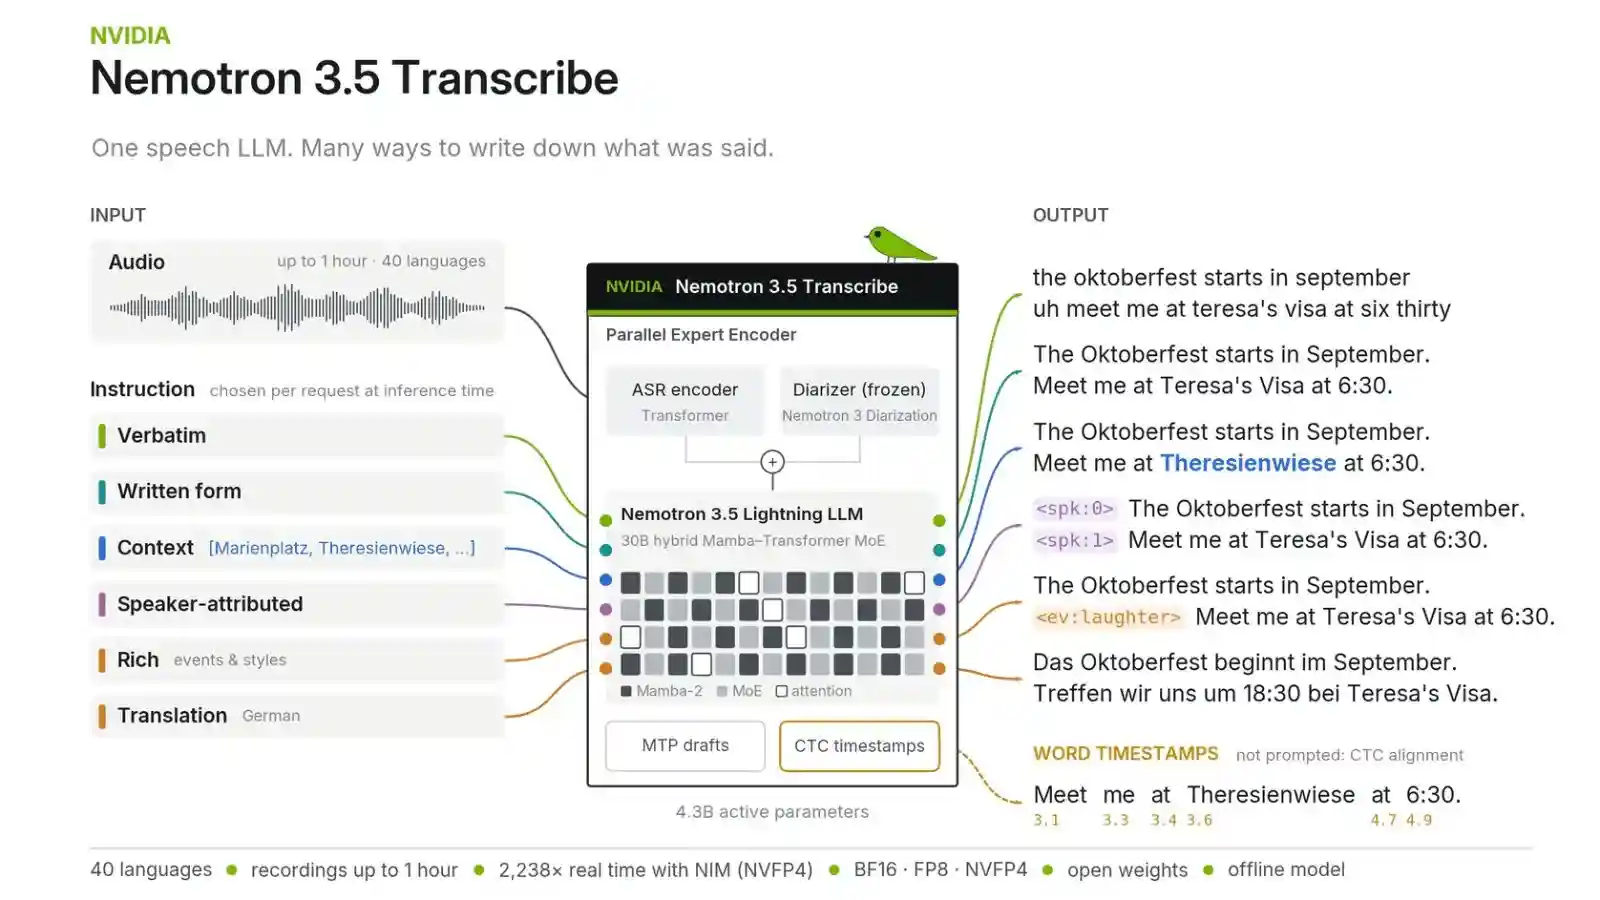
文字起こしに加え、英語から他の31言語への翻訳にも対応する。また、会話の各発言がどの話者のものかを識別する機能も備えており、13言語で利用できる。PC Watchによると、最長1時間の音声記録を一度に処理できるという。
基本バージョンはすでにHugging Faceで公開されている。Nvidiaはモデルの重み、つまり実行に必要なパラメータを公開し、OpenMDW-1.1ライセンスのもとで無料の商用利用を認めた。FP8およびNVFP4で量子化したバージョンは、後日リリースする予定だ。量子化はパラメータの表現精度を下げることで、必要な計算資源とメモリを減らす手法である。
Hugging FaceのOpen ASRテストの結果によると、単語認識の平均エラー率は、英語で5.33%、7言語で4.62%、長時間の音声で10.98%だった。Nvidiaは、これらすべての区分でNemotron 3.5 Transcribeが他の重み公開モデルを上回ったと説明している。
別の性能テストでは、NVFP4版がNvidia RTX PRO 6000 Blackwell Server Edition 1基を搭載したマシンで、100時間分の音声を3分足らずで処理した。この結果は特定の構成におけるものであり、あらゆる機器で1時間の録音が同じ速度で処理されることを意味するものではない。
モデルはすでにvLLMを通じて導入できる。NeMo-Speech.cppを使ったローカル環境での実行は、量子化バージョンと同時に利用可能になる見通しだ。