Nvidia lance un modèle de transcription vocale en 40 langues
Nvidia a annoncé le 28 octobre la sortie de Nemotron 3.5 Transcribe. Il s’agit d’un modèle d’intelligence artificielle qui convertit la parole en texte dans 40 langues.
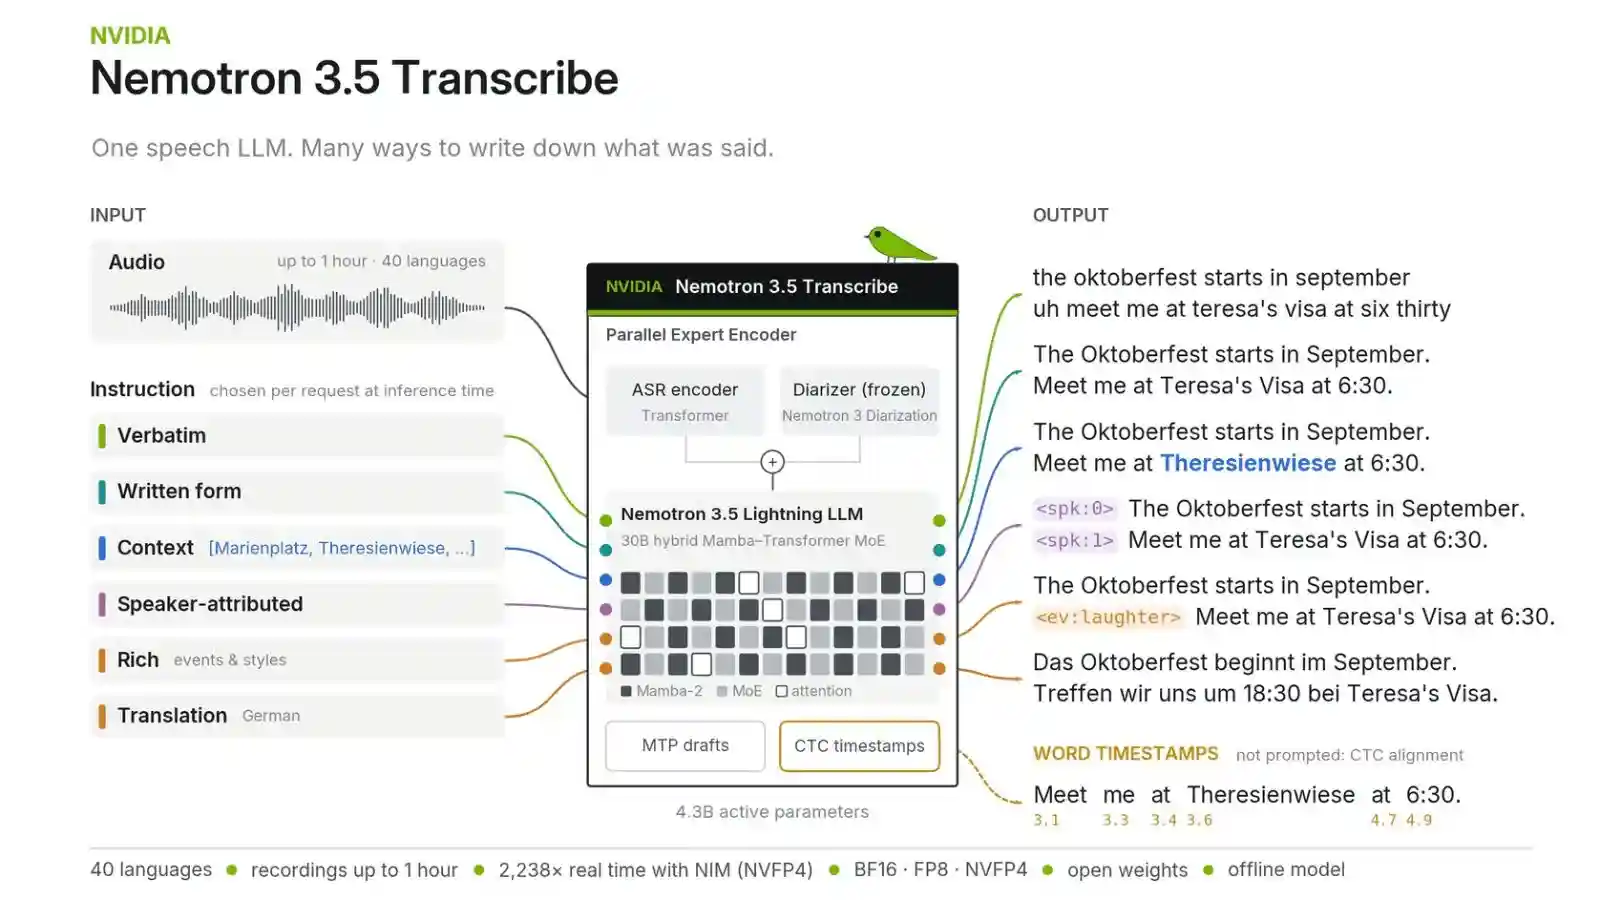
Outre la transcription, la solution traduit de l’anglais vers 31 autres langues. Elle identifie également à quel participant appartient chaque réplique, une fonction disponible dans 13 langues. D’après PC Watch, le modèle peut traiter en une seule fois un enregistrement audio d’une durée maximale d’une heure.
La version de base est déjà disponible sur la plateforme Hugging Face. Nvidia a ouvert les poids du modèle, c’est-à-dire les paramètres nécessaires à son exécution, et autorise son utilisation commerciale gratuite sous la licence OpenMDW-1.1. L’entreprise prévoit de publier plus tard des versions avec quantification FP8 et NVFP4. La quantification réduit la précision de représentation des paramètres, ce qui diminue les besoins en ressources de calcul et en mémoire.
Selon les résultats du test Hugging Face Open ASR, le taux moyen d’erreur de reconnaissance des mots s’est établi à 5,33 % pour l’anglais, à 4,62 % pour sept langues et à 10,98 % pour les enregistrements longs. Nvidia affirme que, dans toutes ces catégories, Nemotron 3.5 Transcribe a devancé d’autres modèles à poids ouverts.
Lors d’une évaluation distincte des performances, la version NVFP4 a traité 100 heures d’audio en moins de trois minutes. Le test a été réalisé sur une machine équipée d’un seul accélérateur Nvidia RTX PRO 6000 Blackwell Server Edition. Ce résultat correspond à une configuration précise et ne signifie pas qu’un enregistrement d’une heure sera traité à la même vitesse sur n’importe quel appareil.
Le modèle peut déjà être déployé via vLLM. L’exécution en local avec NeMo-Speech.cpp sera disponible en même temps que les versions quantifiées.