Nvidia conservera la mémoire HBM4 à 12 couches dans la majorité des accélérateurs Rubin
Selon DigiTimes, Nvidia ne prévoit pas d’abandonner la configuration mémoire d’origine de ses accélérateurs d’intelligence artificielle, malgré les rumeurs d’économies possibles. La plupart des solutions fondées sur l’architecture Rubin devraient conserver la mémoire HBM4 à 12 couches. Cette décision intervient dans un contexte de forte hausse des prix des composants.
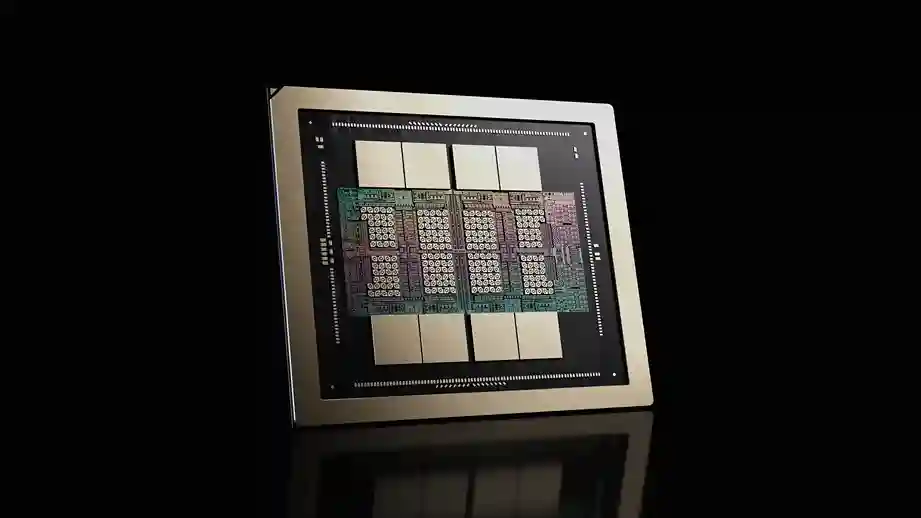
Rappelons que, lors de l’annonce des processeurs graphiques Rubin, une mémoire à 12 couches offrant une bande passante de 22 To/s par processeur avait été clairement indiquée. Par la suite, des informations issues de sources ouvertes ont fait état d’un possible passage à une version à 8 couches afin de réduire les coûts.
L’information de DigiTimes dément ces hypothèses. Toutefois, la publication évoque la majorité des produits. Il est donc impossible d’exclure que certains modèles reçoivent malgré tout une mémoire HBM4 à huit couches.
Il convient de noter que le nombre de couches dans la HBM ne détermine pas seulement la complexité de fabrication et le coût. La capacité d’un empilement et la bande passante globale en dépendent directement, de sorte que la suppression d’une partie des couches entraînerait une dégradation des caractéristiques essentielles de l’accélérateur.
Le coût de la mémoire reste l’un des principaux facteurs de pression sur le marché. D’après les prévisions des analystes de TrendForce, le prix moyen de la HBM augmentera encore de 121 % l’année prochaine.